音声AIの仕組み|音声認識・LLM・音声合成がつながる流れ
電話をかけると、AIが自然な声で応答し、こちらの質問に答えてくれる。数年前までは特別だった体験が、少しずつ身近になってきました。音声AIの仕組みを知らなくても使うことはできますが、導入を検討する立場になると、「なぜ返事に少し間があるのか」「なぜ聞き間違いが起きるのか」「なぜ登録していない質問にうまく答えられないのか」といった疑問が出てきます。こうした疑問に答えるには、音声AIの中で何が起きているのかを、ある程度知っておく必要があります。
この記事では、電話で使われる音声AIが、音声認識(STT)、大規模言語モデル(LLM)、音声合成(TTS)という三つの技術をどのようにつないで会話しているのかを、専門知識のない方にもわかるように解説します。電話ならではの難しさや、三つの技術を一つにまとめたSpeech-to-Speech型との違いにも触れます。数式や専門的な実装の話には立ち入らず、導入や運用の判断に役立つ範囲に絞ってまとめました。
音声AIの全体像
音声AIとは、人の声を聞き取り、その意味を理解し、声で応答するAIの総称です。電話の受付、スマートスピーカー、車の音声操作など、さまざまな場面で使われています。この記事では、主に電話で使われる会話型の音声AIを取り上げます。
三つの技術のリレー
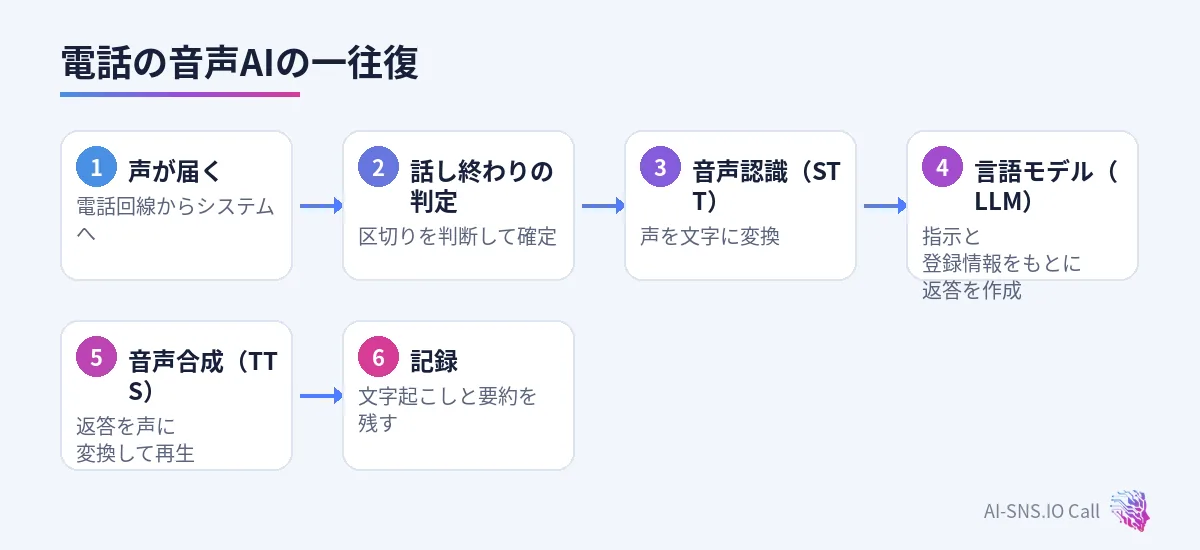
電話の音声AIの多くは、三つの技術がリレーのようにつながって動いています。
- 音声認識(STT:Speech to Text):相手の声を文字に変換します。
- 言語モデル(LLM:Large Language Model):文字になった発話の意味を読み取り、どう返すかを考えて、返答の文章を作ります。
- 音声合成(TTS:Text to Speech):返答の文章を声に変換して、電話の向こうに流します。
相手が話すたびに、このリレーが一回まわります。会話が十往復すれば、リレーも十回まわることになります。
リレーを支える周辺の仕組み
三つの技術だけでは、電話での会話は成り立ちません。周辺には、次のような仕組みが必要です。
- 電話回線との接続:電話の音声をシステムに取り込み、システムの音声を電話に流す仕組みです。クラウドの電話基盤が使われることが多くなっています。
- 発話の区切りの判定:相手が話し終わったのか、まだ話している途中なのかを判断する仕組みです。区切りの判断が早すぎると相手の話をさえぎり、遅すぎると返事に間があきます。
- 割り込みの処理:AIが話している途中で相手が話し始めたときに、AIの発話を止める仕組みです。バージインとも呼ばれます。
- 知識の参照:事業者が登録した営業時間やよくある質問などの情報を、言語モデルが参照できるようにする仕組みです。
- 記録:会話の内容を文字起こしや要約として残す仕組みです。
これらがそろってはじめて、電話での自然な会話に近づきます。
電話の音声AIとチャットボットの違い
文字でやりとりするチャットボットと、電話の音声AIは、言語モデルを使って返答を考えるという点では共通しています。大きな違いは、入口と出口が「声」であることです。
チャットボットでは、相手が入力した文字がそのまま言語モデルに届きます。音声AIでは、まず声を文字に変換する必要があり、その段階で聞き間違いが起こる可能性があります。また、チャットでは返答を読むのに数秒かかっても気になりませんが、電話の会話では、返事が少し遅れるだけで「間」として強く感じられます。電話の音声AIは、チャットボットよりも、正確さと速さの両方で厳しい条件のもとで動いているのです。
音声認識(STT)
リレーの最初の走者が、音声認識です。相手の声を文字に変換する役割を担います。
音声認識がしていること
音声認識は、音の波形から、話された言葉を推定する技術です。人の声には、話す人、話す速さ、声の高さ、周囲の音などによって、大きなばらつきがあります。音声認識は、大量の音声と文字の組み合わせから学習したモデルを使って、こうしたばらつきの中から、もっともありそうな言葉の並びを選び出しています。
ここで大切なのは、音声認識が出す結果は「推定」であるということです。音声認識は、話された言葉を確実に知っているわけではなく、あくまで「おそらくこう言った」という推定を出しています。推定が外れれば、聞き間違いになります。
ストリーミング認識
電話の音声AIでは、相手が話し終わるのを待ってからまとめて認識するのではなく、話している途中から少しずつ認識を進める「ストリーミング」の方式がよく使われます。話し終わった時点で、ほぼ認識が終わっていれば、次の走者である言語モデルにすぐに文字を渡せます。
ストリーミング認識では、話している途中の認識結果が、後から修正されることがあります。たとえば、途中まで「いちがつ」と認識していたものが、続きを聞いて「しちがつ」に修正される、といったことです。どの時点の結果を確定として扱うかは、応答の速さと正確さのバランスに関わります。
聞き間違いが起きやすい言葉
音声認識で聞き間違いが起きやすいのは、次のような言葉です。
- 固有名詞:人名、地名、商品名、社内用語など、一般的でない言葉
- 数字:日付、時間、電話番号、金額など、音が似ている数字の組み合わせ
- 同音異義語:音は同じで意味が違う言葉
- 短い返事:「はい」「いえ」など、短く、前後の文脈がないと判断しにくい発話
電話の音声AIの設計では、こうした言葉を聞き取るときに、復唱して確認する、一つずつ区切って聞く、といった工夫で、聞き間違いの影響を小さくします。聞き取りの精度を高める工夫は、電話の音声認識の精度を上げるにはで詳しく解説しています。
言語モデル(LLM)
リレーの二番目の走者が、言語モデルです。音声認識が作った文字を受け取り、相手が何を求めているのかを理解して、返答の文章を作ります。
言語モデルがしていること
大規模言語モデル(LLM)は、大量の文章から言葉の使われ方を学習したモデルです。与えられた文章の続きとして、もっともふさわしい言葉を順番に選んでいくことで、文章を作ります。会話の流れ、相手の質問、あらかじめ与えられた指示や情報をもとに、「この場面ではこう返すのがよい」という返答を組み立てます。
言語モデルは、文法的に自然で、文脈に合った文章を作るのが得意です。一方で、自分が知らないことについても、もっともらしい文章を作ってしまうことがあります。事実と違う内容をあたかも正しいかのように答えてしまう現象は、ハルシネーションと呼ばれることがあります。
指示(プロンプト)の役割
電話の音声AIでは、言語モデルにあらかじめ指示を与えて、役割や話し方、してはいけないことを決めておきます。この指示はプロンプトと呼ばれます。たとえば、次のような内容です。
- あなたは〇〇の電話受付です
- 丁寧に、短く、わかりやすく話してください
- 予約の確定はせず、希望を聞き取って担当者に引き継いでください
- わからないことは推測で答えず、担当者から連絡すると伝えてください
- 医療や法律に関する個別の判断はしないでください
指示が明確であるほど、言語モデルの返答は安定します。電話の音声AIのプロンプトの書き方は、電話AIエージェントのプロンプト設計で詳しく解説しています。
事業者の情報を参照させる
言語モデルは、何もしなければ、その事業者の営業時間やサービスの内容を知りません。そこで、事業者が登録した情報(営業時間、所在地、よくある質問と回答、Webサイトの内容など)を、会話のたびに言語モデルが参照できるようにします。
よく使われるのが、相手の質問に関係のありそうな情報を検索して取り出し、言語モデルに渡す方法です。この方法は、RAG(検索拡張生成)と呼ばれます。言語モデルは、渡された情報をもとに返答を作るため、事業者の情報に沿った答えを返しやすくなります。RAGの仕組みについては、RAGとは?音声AIが社内情報を使って答える仕組みで解説しています。
電話向けの返答の作り方
電話の音声AIでは、言語モデルが作る返答にも、電話ならではの配慮が必要です。画面で読む文章と、耳で聞く文章は違います。
- 一つの返答は短くし、一度に多くの情報を詰め込まない
- 箇条書きや表、記号など、耳で聞いてもわからない表現は使わない
- 数字や日時は、聞き取りやすい言い方にする
- 相手に答えてほしいことがあるときは、質問を一つに絞る
こうした配慮も、プロンプトの指示として与えておくのが一般的です。
音声合成(TTS)
リレーの最後の走者が、音声合成です。言語モデルが作った返答の文章を、声に変換して相手に届けます。
音声合成がしていること
音声合成は、文章を読み上げる声を作る技術です。かつての音声合成は、機械的で抑揚の少ない声が特徴でしたが、近年は人の声に近い、自然な抑揚の声を作れるようになってきました。声の高さ、話す速さ、声の雰囲気などを調整できるものも多くあります。
音声合成でも、音声認識と同じようにストリーミングの方式が使われます。返答の文章がすべてできあがるのを待たずに、最初の一文ができた時点で読み上げを始めれば、相手が返事を聞き始めるまでの時間を短くできます。
日本語の音声合成の難しさ
日本語の音声合成には、日本語ならではの難しさがあります。
- 漢字の読み:同じ漢字でも、文脈によって読み方が変わります。人名や地名は特に読み間違えやすく、たとえば店名や担当者の名前を正しく読めないことがあります。
- アクセント:同じ読みでも、アクセントによって意味が変わる言葉があります。アクセントが不自然だと、聞き手は違和感を覚えます。
- 数字と記号:「1/2」「10:00」「3F」など、数字と記号の組み合わせをどう読むかは、文脈によって変わります。
こうした読み間違いを防ぐため、読み方を登録できる仕組みを使ったり、返答の文章の段階で読みやすい書き方にしたりする工夫が行われます。日本語の音声合成を自然にするコツは、日本語の音声合成(TTS)を自然にするコツで詳しく紹介しています。
声の選び方
音声合成の声は、事業者の印象を左右します。落ち着いた声、明るい声、ゆっくりした声など、業種やお客様の層に合った声を選ぶことが大切です。また、自社のスタッフの声をもとに声を作るボイスクローンという技術もありますが、本人の同意や用途の管理など、注意すべき点があります。詳しくはボイスクローンをビジネスで使うときの注意点で解説しています。
電話ならではの難しさ
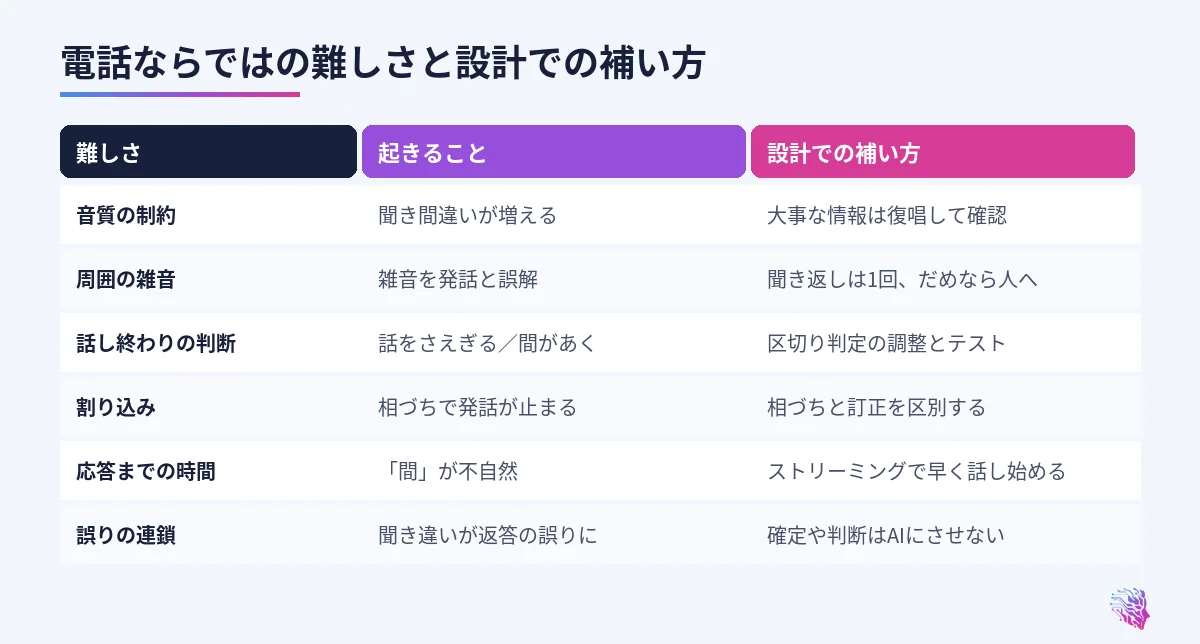
三つの技術の仕組みがわかったところで、電話という環境が音声AIにとってなぜ難しいのかを整理しておきましょう。
音質の制約
電話の音声は、対面で聞く声と比べて、伝わる音の幅が限られています。回線や端末によっては、声がこもったり、途切れたりすることもあります。音声認識は、こうした制約のある音声から言葉を推定しなければならないため、対面やマイクで直接録音した音声よりも、聞き間違いが起きやすくなります。
周囲の雑音
電話をかけてくる相手は、静かな部屋にいるとは限りません。屋外、駅、車の中、にぎやかな店内など、さまざまな場所からかけてきます。周囲の話し声や音楽、車の走行音などが混ざると、音声認識はそれを相手の発話の一部と誤解したり、相手の声を聞き取れなかったりします。
話し終わりの判断
対面の会話では、人は相手の表情やしぐさから、話し終わったかどうかを判断しています。電話では、声だけが手がかりです。音声AIは、相手の声が途切れた時間の長さなどから、話し終わったかどうかを判断します。少し考えるために言葉を止めた相手を「話し終わった」と判断すると、AIは相手の話をさえぎって返答を始めてしまいます。逆に、判断を慎重にしすぎると、返事までの間が長くなります。
割り込み
電話の会話では、相手がAIの話の途中で話し始めることがよくあります。「はい、わかりました」と相づちを打つこともあれば、「いや、そうじゃなくて」と訂正することもあります。音声AIは、相手が話し始めたら自分の発話を止めるべきか、相づちとして聞き流すべきかを判断しなければなりません。この割り込みの扱いは、会話の自然さに大きく影響します。詳しくはバージイン(割り込み)とはで解説しています。
応答までの時間
三つの技術がリレーでつながっているため、相手が話し終わってからAIが返事を始めるまでには、音声認識の確定、言語モデルによる返答の作成、音声合成の開始という三つの段階の時間がかかります。どれか一つが遅れると、相手には「間」として感じられます。この応答までの時間はレイテンシと呼ばれ、音声AIの自然さを左右する重要な要素です。レイテンシについては、音声AIの応答遅延(レイテンシ)とはで詳しく解説しています。
誤りが重なること
リレーの構造には、前の走者の誤りが後ろに引き継がれるという性質もあります。音声認識が言葉を聞き間違えれば、言語モデルは聞き間違えた言葉をもとに返答を考え、音声合成はその返答をそのまま読み上げます。一つの段階の小さな誤りが、最終的な返答の誤りにつながることがあるのです。そのため、電話の音声AIの設計では、大事な情報を復唱して確認するなど、誤りに途中で気づける仕組みを組み込むことが大切です。
Speech-to-Speech型との違い
ここまで、音声認識、言語モデル、音声合成をリレーでつなぐ方式を説明してきました。これとは別に、声を直接受け取り、声で直接返す方式も登場しています。Speech-to-Speech型、あるいは音声ネイティブ型などと呼ばれることがあります。
一つのモデルで声から声へ
Speech-to-Speech型では、相手の声をいったん文字に変換するのではなく、声のままモデルに入力し、モデルが声で直接返答を出力します。リレーの三つの走者を、一人の走者がまとめて担うイメージです。
この方式の利点として期待されているのは、段階の受け渡しが減ることによる応答の速さや、声の調子や間といった、文字にすると失われる情報を扱いやすいことです。
リレー型の利点
一方、リレー型にも利点があります。各段階が分かれているため、音声認識の結果、言語モデルの返答、音声合成の設定を、それぞれ確認したり、調整したりしやすいのです。たとえば、聞き間違いが多ければ音声認識の設定を見直し、返答の内容に問題があれば言語モデルの指示を直す、というように、問題の場所を特定しやすくなります。会話の記録も、文字として自然に残ります。
どちらを選ぶか
どちらの方式が適しているかは、用途や求める品質、運用のしやすさによって変わります。技術は急速に変化しているため、特定の方式が常に優れているとは言い切れません。導入を検討する際は、方式の名前よりも、実際に自社の電話で試したときの応答の速さ、聞き取りの正確さ、返答の内容の確かさ、記録の残り方を、テストで確認することが大切です。テストの方法は、音声AIのテスト方法で紹介しています。
リレーを支える周辺技術をもう少し詳しく
三つの技術の陰で、会話の自然さを支えている周辺の技術があります。導入の際に話題にのぼりやすいものを、もう少し詳しく見ておきましょう。
発話区間の検出
音声AIは、届いた音のうち、どこからどこまでが人の発話なのかを判断する必要があります。この判断を、発話区間の検出などと呼びます。発話区間を正しく切り出せないと、話の途中で認識が確定してしまったり、雑音を発話と誤解したりします。話し終わりの判定も、この技術と密接に関わっています。
雑音の抑制
周囲の雑音を減らし、相手の声を聞き取りやすくする処理です。雑音を抑えすぎると、相手の声の一部まで削ってしまうことがあり、逆に抑えが弱いと、雑音が音声認識の妨げになります。電話をかけてくる環境が多様なため、さまざまな環境でのテストが大切です。
エコーへの対処
電話では、AIが話した声が相手の端末から回線に戻ってきて、AI自身の声を相手の発話と誤解してしまうことがあります。これを防ぐ処理が、エコーへの対処です。この処理がうまく働かないと、AIが自分の声に反応して発話を止めてしまうなど、会話が不自然になります。
会話の状態の管理
音声AIは、会話の中で聞き取った情報(名前、希望の日時、用件など)を覚えておき、次の返答に活かす必要があります。どの情報をすでに聞き取ったのか、次に何を聞くべきかを管理する仕組みがあれば、同じことを何度も聞き返すことを防げます。
人への引き継ぎ
音声AIが対応しきれない場面で、人に電話をつなぐ、あるいは折り返しの依頼として記録する仕組みです。引き継ぐ際に、AIが聞き取った内容を担当者に渡せれば、相手は同じ説明を繰り返さずに済みます。どの条件で引き継ぐのかは、事業者が決めておく必要があります。
音声AIについてのよくある誤解
音声AIについては、期待と不安の両方から、いくつかの誤解が生まれやすくなっています。
誤解1:音声AIは人と同じように理解している
音声AIは、言葉の使われ方のパターンから、もっともふさわしい返答を作っています。人のように経験や常識にもとづいて理解しているわけではありません。文脈に合った自然な返答ができる一方で、思いがけない誤りをすることもあります。人と同じように任せられる、と考えるのではなく、得意なことと苦手なことを知ったうえで役割を決めることが大切です。
誤解2:性能の高いAIを選べばすべて解決する
音声認識や言語モデルの性能が高ければ、聞き取りや返答の質は上がりやすくなります。しかし、参照する情報が古い、指示があいまい、引き継ぎのルールが決まっていない、といった問題は、AIの性能では解決できません。AIの性能と同じくらい、情報の整備と設計が品質を左右します。
誤解3:一度設定すればあとは放っておける
音声AIは、設定した直後よりも、記録を読みながら直していった後のほうが、品質が安定します。事業の情報も変わっていくため、情報の更新も続けなければなりません。導入はゴールではなく、改善のスタートだと考えておきましょう。
誤解4:音声AIを使うと人の仕事がなくなる
電話の音声AIが担うのは、主に一次対応です。予約や契約の確定、専門的な判断、感情的な配慮が必要な対応は、引き続き人の仕事です。むしろ、定型的な対応をAIが受け持つことで、人は人にしかできない対応に時間を使えるようになります。
一回のやりとりを追いかけてみる
ここまでの説明を、具体的な一回のやりとりに当てはめてみましょう。お客様が飲食店に電話をかけ、「明日の夜、四人で入れますか」と尋ねた場面を想定します。
声が届くまで
お客様の声は、電話回線を通ってシステムに届きます。システムは、お客様が話している間、音声を細かく区切って音声認識に送り続けます。
音声認識
音声認識は、届いた音声から、少しずつ言葉を推定していきます。「明日の」「夜」「四人で」「入れますか」と、話している途中から認識が進みます。お客様の声が途切れると、話し終わりの判定が働き、「話し終わった」と判断された時点で、認識結果が確定します。
言語モデル
確定した文字「明日の夜、四人で入れますか」が、言語モデルに渡されます。言語モデルは、あらかじめ与えられた指示(予約の確定はしない、希望を聞き取って担当者に引き継ぐ)と、参照できる情報(営業時間、席の種類など)をもとに、返答を考えます。空席の状況はAIには確定できないため、たとえば「明日の夜、四名様のご希望ですね。お時間のご希望はございますか。空き状況は担当者が確認して、折り返しご連絡いたします」といった返答を作ります。
音声合成
返答の最初の一文ができた時点で、音声合成が読み上げを始めます。お客様の耳には、少しの間のあとに、AIの声で返答が聞こえてきます。
続きの会話と記録
お客様が「七時くらいで」と答えれば、またリレーが一回まわります。名前と連絡先を聞き取り、復唱して確認したら、会話は終わります。会話の内容は文字起こしと要約として記録され、スタッフは空き状況を確認したうえで、お客様に予約の可否を連絡します。予約の確定は、スタッフが行います。
このように、一見シンプルな一往復の中にも、いくつもの段階と判断が含まれています。そして、そのどこかで誤りや遅れが生じると、会話の質に影響します。音声AIの仕組みを知っておくと、うまくいかなかったときに、どの段階に原因がありそうかを考えやすくなります。
音声AIを評価するときの観点
仕組みを理解したうえで、実際に音声AIを評価するときには、どのような観点で見ればよいのでしょうか。三つの技術と周辺の仕組みに対応させて、評価の観点を整理します。
聞き取りの観点
- 自社の電話でよく出てくる固有名詞(店名、商品名、地名)を正しく聞き取れるか
- 日付、時間、電話番号などの数字を正しく聞き取れるか
- 早口の人、ゆっくり話す人、方言のある人の発話をどこまで聞き取れるか
- 周囲が騒がしい場所からの電話でも、相手の声を聞き分けられるか
- 聞き取れなかったときに、自然に聞き返せるか
返答の内容の観点
- 登録した情報に沿って、正しく答えられるか
- 登録していない質問に対して、推測で答えず、担当者への引き継ぎを案内できるか
- 予約の確定や専門的な判断など、してはいけないことをしないか
- 一つの返答が長すぎず、耳で聞いてわかりやすいか
- 会話の流れを覚えていて、同じことを何度も聞き返さないか
声の観点
- 声の雰囲気が、自社の業種やお客様の層に合っているか
- 店名や人名、数字を正しく読めるか
- 話す速さが、聞き取りやすい速さになっているか
- 長く聞いていても疲れない声か
会話の流れの観点
- 相手が話し終わってから返事が始まるまでの間が、不自然に長くないか
- 相手が考えながら話しているときに、話をさえぎらないか
- 相手が途中で話し始めたときに、適切に発話を止められるか
- 相づちを、割り込みと誤解しないか
記録の観点
- 会話の内容が文字起こしとして残るか
- 要約が、用件や約束した対応を正しく含んでいるか
- 記録を誰が、どこで確認できるか
これらの観点を、自社の電話でよくある場面を想定したテスト通話で確認していきます。すべての観点で完璧である必要はありませんが、自社にとって重要な観点(たとえば、固有名詞の聞き取りや、してはいけないことをしないこと)で問題がないかは、導入前に必ず確かめておきましょう。
場面で見る、音声AIがつまずきやすいところ
仕組みの説明だけではイメージしにくいかもしれません。ここでは、電話でよくある場面を例に、音声AIのどの段階でつまずきが起きやすいのか、そしてどう補えばよいのかを見ていきます。
場面1:相手が名前を名乗る
「やまさきです」と名乗られたとき、音声認識は「山崎」「山﨑」「山先」など、複数の候補の中から一つを選びます。そもそも音だけでは漢字は決まりませんし、「やまざき」と聞こえる可能性もあります。このつまずきは音声認識の段階で起きますが、AIの性能だけで解決するのは難しい問題です。補い方としては、名前の漢字にこだわらず、読みで記録する、必要なら折り返しの際にスタッフが確認する、といった運用が現実的です。
場面2:相手が日付を伝える
「来週の火曜日」と言われたとき、AIは今日の日付をもとに、具体的な日付に置き換える必要があります。「来週」が何を指すのかは人によって解釈が分かれることもあり、言語モデルの段階での誤りにつながります。補い方は、具体的な日付と曜日を復唱して確認することです。「○月○日の火曜日でよろしいですか」と確かめれば、相手が違いに気づけます。
場面3:相手が考えながら話す
「えっと、その、先週お願いした件なんですけど……」と、言いよどみながら話す人は少なくありません。途中の沈黙を話し終わりと判断してしまうと、AIが相手の話をさえぎってしまいます。これは話し終わりの判定の段階のつまずきです。補い方は、区切りの判定を調整し、実際の通話に近いテストで、さえぎりが起きないかを確認することです。
場面4:登録していないことを聞かれる
「駐車場の近くにコンビニはありますか」のように、事業者が登録していないことを聞かれる場面もあります。言語モデルは、もっともらしい返答を作ろうとするため、知らないことを推測で答えてしまう恐れがあります。補い方は、登録した情報にないことには答えず、担当者からの折り返しを案内するように指示しておくことです。
場面5:相手が感情的になっている
困りごとや不満を抱えて電話をかけてくる人もいます。音声AIは、言葉の内容から状況を推し量ることはできても、相手の気持ちに寄り添った対応には限界があります。補い方は、こうした場面を早めに人へ引き継ぐ条件として決めておくことです。
このように、つまずきは三つの技術や周辺の仕組みのそれぞれで起こりえます。どの段階で起きているかがわかれば、補い方も見つけやすくなります。
導入する側が知っておきたいこと
最後に、音声AIを導入する側として、仕組みの理解をどう活かせばよいかをまとめます。
誤りが起きる前提で設計する
音声認識も言語モデルも、推定にもとづいて動いています。どれだけ性能が上がっても、誤りがゼロになることはありません。大事なのは、誤りが起きたときに影響を小さくする設計です。大事な情報を復唱する、AIに確定や判断をさせない、わからないときは人に引き継ぐ、といった工夫が、仕組みの弱点を補います。
情報の質がAIの質を決める
言語モデルが参照する情報が古かったり、あいまいだったりすると、AIの返答も古く、あいまいになります。営業時間、よくある質問、サービスの内容など、AIに渡す情報を整え、更新し続けることが、AIの品質を保つうえでもっとも効果的な取り組みの一つです。情報の整え方は、問い合わせ対応のナレッジベースの作り方で紹介しています。
記録を読んで改善する
音声AIの会話は、文字起こしとして記録に残ります。記録を読めば、どこで聞き間違いが起きたのか、どの質問に答えられなかったのか、どこで会話が不自然になったのかがわかります。記録を定期的に読み、指示や情報を直していくことで、音声AIは少しずつ自社に合った形になっていきます。
人との役割分担を決める
音声AIは、電話の一次対応を担う道具です。予約や契約の確定、専門的な判断、感情的な配慮が必要な対応は、人が受け持つべき領域です。AIと人の役割分担をはっきり決めることが、仕組みの限界を理解したうえでの、もっとも確かな使い方です。AI電話受付の役割分担については、AI電話受付とは?で詳しく解説しています。
音声AIに関する用語集
最後に、この記事で登場した用語を、改めて整理しておきます。
STT(音声認識):Speech to Textの略。人の声を文字に変換する技術です。
LLM(大規模言語モデル):Large Language Modelの略。大量の文章から言葉の使われ方を学習し、文章を作るモデルです。
TTS(音声合成):Text to Speechの略。文章を声に変換する技術です。
プロンプト:言語モデルに与える指示のことです。役割、話し方、してはいけないことなどを書きます。
RAG(検索拡張生成):質問に関係する情報を検索して取り出し、言語モデルに渡して返答を作らせる方法です。
ハルシネーション:言語モデルが、事実と違う内容をもっともらしく答えてしまう現象です。
ストリーミング:処理をまとめて行うのではなく、データが届くそばから少しずつ処理する方式です。
レイテンシ:相手が話し終わってから、AIが返事を始めるまでの時間のことです。
バージイン:AIが話している途中で相手が話し始めたときに、AIの発話を止める仕組みです。
Speech-to-Speech型:声を文字に変換せず、声のまま受け取り、声で直接返す方式です。
AI-SNS.IO Callでの位置づけ
私たちAI-SNS.IOのCallでは、AIエージェントの画面で、ファイル、Webサイト、Q&A、Notionなどのナレッジソースを登録し、AIが参照する情報を整えられます。プレイグラウンドでは、エージェントの応答を事前に試し、答え方を確認できます。通話の記録は通話履歴とAIによる通話要約として残ります。Callでは、予約や契約の確定はAIではなく事業者のスタッフが行う前提で設計しています。
日本の電話番号の提供は準備中です。現在はデモで着信をシミュレーションして体験できます。電話回線でのAI応答を含む各機能の提供状況はCallの機能一覧で、技術的な情報はCallのドキュメントで、画面ごとの操作はCallの使い方ガイドでご確認ください。エージェントの作り方は、CallでAIエージェントを作る手順でも紹介しています。
読み終えたら試してほしいこと
最後に、この記事の内容を自社の電話に当てはめるための、小さな練習を紹介します。
一つ目は、自社にかかってくる電話を思い出し、よくある用件を五つほど書き出してみることです。そのうえで、それぞれの用件で、相手がどのような言葉を使いそうか、どこで聞き間違いが起きそうかを考えてみます。固有名詞が多い用件、数字が多い用件、感情がこもりやすい用件が見えてくるはずです。
二つ目は、それぞれの用件について、AIに任せられる部分と、人が対応すべき部分を分けてみることです。営業時間や場所の案内はAIに任せやすく、予約や契約の確定、専門的な判断、苦情への対応は人が担う、といった線引きが見えてきます。
三つ目は、AIに任せる部分について、AIが参照すべき情報がすでにまとまっているかを確認することです。情報がばらばらだったり、古かったりすれば、まずはそこを整えることが、音声AIの品質を上げる近道になります。
この三つを済ませておけば、音声AIのサービスを比べるときにも、テスト通話をするときにも、何を確認すればよいかがはっきりします。
「音声AIの仕組み|音声認識・LLM・音声合成がつながる流れ」の続きとして、製品全体はAI-SNS.IO Callのトップで確認でき、アカウント登録は月額0円から始めるから進められます。
まとめ
電話の音声AIは、音声認識(STT)が声を文字にし、言語モデル(LLM)が意味を理解して返答を考え、音声合成(TTS)が返答を声にする、という三つの技術のリレーで動いています。周辺には、話し終わりの判定、割り込みの処理、事業者の情報の参照、記録といった仕組みがあり、これらがそろってはじめて自然な会話に近づきます。
電話という環境には、音質の制約、周囲の雑音、話し終わりの判断、割り込み、応答までの時間といった難しさがあり、リレーの構造ゆえに誤りが重なることもあります。声から声へ直接返すSpeech-to-Speech型も登場していますが、どの方式でも、自社の電話で実際に試して確かめることが大切です。
仕組みを知っておけば、音声AIに過度な期待をせず、誤りが起きる前提で設計し、情報を整え、記録を読み、人との役割分担を決める、という確かな使い方ができます。
よくある質問
音声AIはどのような仕組みで会話しているのですか?
多くの電話の音声AIは、相手の声を文字にする音声認識(STT)、文字の意味を理解して返答を作る言語モデル(LLM)、返答を声にする音声合成(TTS)という三つの技術をリレーのようにつないで動いています。相手が話すたびにこのリレーが一回まわり、周辺では話し終わりの判定や割り込みの処理、事業者の情報の参照、記録などの仕組みが支えています。
STT、LLM、TTSとは何ですか?
STTはSpeech to Textの略で、声を文字に変換する音声認識の技術です。LLMはLarge Language Modelの略で、大量の文章から学習し、文脈に合った文章を作る大規模言語モデルです。TTSはText to Speechの略で、文章を声に変換する音声合成の技術です。
なぜ音声AIの返事には少し間があるのですか?
相手が話し終わったかどうかを判断し、音声認識の結果を確定させ、言語モデルが返答を作り、音声合成が読み上げを始める、という複数の段階を経るためです。それぞれの段階に時間がかかり、合計が「間」として感じられます。処理を少しずつ進めるストリーミングなどの工夫で、この時間を短くする取り組みが行われています。
音声AIが聞き間違えるのはなぜですか?
音声認識は、話された言葉を確実に知っているわけではなく、音から「おそらくこう言った」と推定しているためです。電話は音質に制約があり、周囲の雑音が混ざることもあります。固有名詞や数字、短い返事は特に聞き間違いが起きやすいため、大事な情報は復唱して確認する設計が大切です。
音声AIが事実と違うことを答えることはありますか?
あります。言語モデルは、知らないことについても、もっともらしい文章を作ってしまうことがあります。これを防ぐために、事業者が登録した情報を参照させる、わからないことは推測で答えず担当者に引き継ぐよう指示する、予約の確定や専門的な判断をさせない、といった設計を行います。
音声AIは自社の営業時間やサービスをどうやって知るのですか?
事業者が登録した営業時間、よくある質問、Webサイトの内容などの情報を、会話のたびに言語モデルが参照できるようにします。質問に関係する情報を検索して言語モデルに渡すRAG(検索拡張生成)という方法がよく使われます。登録した情報が古いと返答も古くなるため、情報の更新が欠かせません。
Speech-to-Speech型とは何ですか?
声をいったん文字に変換せず、声のままモデルに入力し、モデルが声で直接返す方式です。段階の受け渡しが減ることによる応答の速さや、声の調子などの情報を扱いやすいことが期待されています。一方、リレー型は各段階を個別に確認・調整しやすい利点があります。どちらが適しているかは、自社の電話で試して確かめるのが確実です。
チャットボットと電話の音声AIは何が違いますか?
返答を考える部分には、どちらも言語モデルが使われることがあります。違いは、電話の音声AIでは入口と出口が声であることです。声を文字にする段階で聞き間違いが起こりうること、返事のわずかな遅れが「間」として強く感じられること、耳で聞いてわかる短い返答が求められることなど、電話ならではの難しさがあります。
音声AIを導入するときに、まず何を確認すればよいですか?
自社の電話でよくある場面を想定したテスト通話で、固有名詞や数字の聞き取り、登録した情報に沿った返答、してはいけないことをしないか、返事までの間、割り込みの扱い、記録の残り方を確かめましょう。特に、予約の確定や専門的な判断をしないこと、わからないときに人へ引き継ぐことは、必ず確認しておきたい点です。
音声AIの品質を上げるために、事業者ができることはありますか?
AIが参照する情報を整え、最新の状態に保つことがもっとも効果的です。あわせて、会話の記録を定期的に読み、聞き間違いや答えられなかった質問を見つけて、情報や指示を直していきます。大事な情報を復唱する、AIと人の役割分担をはっきりさせるといった設計も、品質を安定させるのに役立ちます。
音声AIは名前の漢字を正しく聞き取れますか?
音だけでは漢字は決まらないため、名前の漢字を正確に聞き取るのは難しい場合があります。同じ読みで複数の漢字がある名前も多いため、読みで記録しておき、必要に応じてスタッフが折り返しの際に確認するといった運用が現実的です。
音声AIの仕組みを理解していないと導入できませんか?
詳しい技術を知らなくても導入はできます。ただ、三つの技術がリレーのようにつながっていること、それぞれの段階で誤りが起こりうること、品質は参照する情報と設計に大きく左右されることを知っておくと、テストの観点や改善の方向を考えやすくなります。
音声AIは方言や早口にも対応できますか?
音声認識は多様な話し方を学習していますが、方言の強い話し方や、とても早口の話し方では、聞き取りの精度が下がることがあります。対応の程度はサービスや条件によって異なるため、自社のお客様に多い話し方を想定したテスト通話で確かめておくと安心です。
音声AIの「割り込み」対応とは何ですか?
AIが話している途中で相手が話し始めたときに、AIが発話を止めて相手の話を聞く仕組みです。バージインとも呼ばれます。うまく働かないと、相手の訂正を聞き逃したり、逆に相づちのたびに発話が止まったりします。相づちと訂正を区別できるかが、会話の自然さを左右します。
音声AIの会話の記録は何に使えますか?
文字起こしや要約は、担当者への引き継ぎ、折り返しの準備、品質の改善に使えます。特に、聞き間違いが起きた場面や、AIが答えられなかった質問を記録から見つけ、登録情報や指示を直していくことが、品質を安定させる近道になります。